Представьте, что робот поисковой системы — это курьер с ограниченным рабочим днём. Ему нужно обойти ваш сайт и забрать свежие страницы. Если половину времени он тратит на мусорные адреса, до важных материалов он доберётся позже или не доберётся вовсе. Вот это и называется краулинговым бюджетом — количество страниц, которые поиск готов обходить за определённое время.
Для маленького сайта из ста страниц тема почти не имеет значения. Когда адресов сотни тысяч, а часть из них — дубли фильтров и параметров сортировки, бюджет обхода становится одной из главных технических задач.

Из чего складывается бюджет
С одной стороны — ресурсы сайта: скорость ответа сервера, стабильность, наличие ошибок. С другой — интерес поиска: чем больше на сайте полезного и обновляемого контента, тем охотнее он его обходит. Если сервер отвечает медленно, часть обхода уходит на ожидание, и робот успевает меньше.
Поэтому первое, что стоит проверить, — не настройки, а скорость: как быстро открываются страницы под нагрузкой, нет ли таймаутов, как ведёт себя хостинг. Мы разбирали это в материале про скорость и Core Web Vitals, и для темы обхода это база.
Как понять, что бюджет утекает
- В логах сервера много запросов робота к страницам, которых нет в sitemap, или к адресам с параметрами.
- В панелях вебмастеров растёт число страниц «обнаружено, но не проиндексировано».
- Новые материалы ждут индексации неделями, хотя раньше попадали в индекс за день-два.
- Отчёты показывают, что обход чаще заходит на архив, теги и фильтры, чем на карточки товаров или статьи.
Первым делом я смотрю на лог-файлы сервера: другого способа увидеть, куда именно ходит робот, просто нет. Разбор логов быстро показывает, где теряется время.
Что съедает обход
Список типовых «пожирателей» одинаков почти на любом сайте с каталогом или большим архивом.
- Фильтры и сортировки: один товар превращается в десятки адресов.
- Пагинация без ограничений: страницы вида /page/300 часто не нужны ни людям, ни поиску, но обходятся регулярно.
- Поиск по сайту и календари: тысячи адресов, которые не должны попадать в индекс.
- Старые зеркала, тестовые поддомены, дубли протоколов и слэшей.
- Цепочки редиректов и битые ссылки: робот тратит время на переходы в никуда.
- Мусорные страницы из пользовательского контента: анкеты, корзины, списки сравнения.
Отдельно стоят устаревшие разделы, которые вы давно не обновляете, но не удаляете. Если такие страницы не нужны людям, они не нужны и поиску.
Что делать: порядок работ
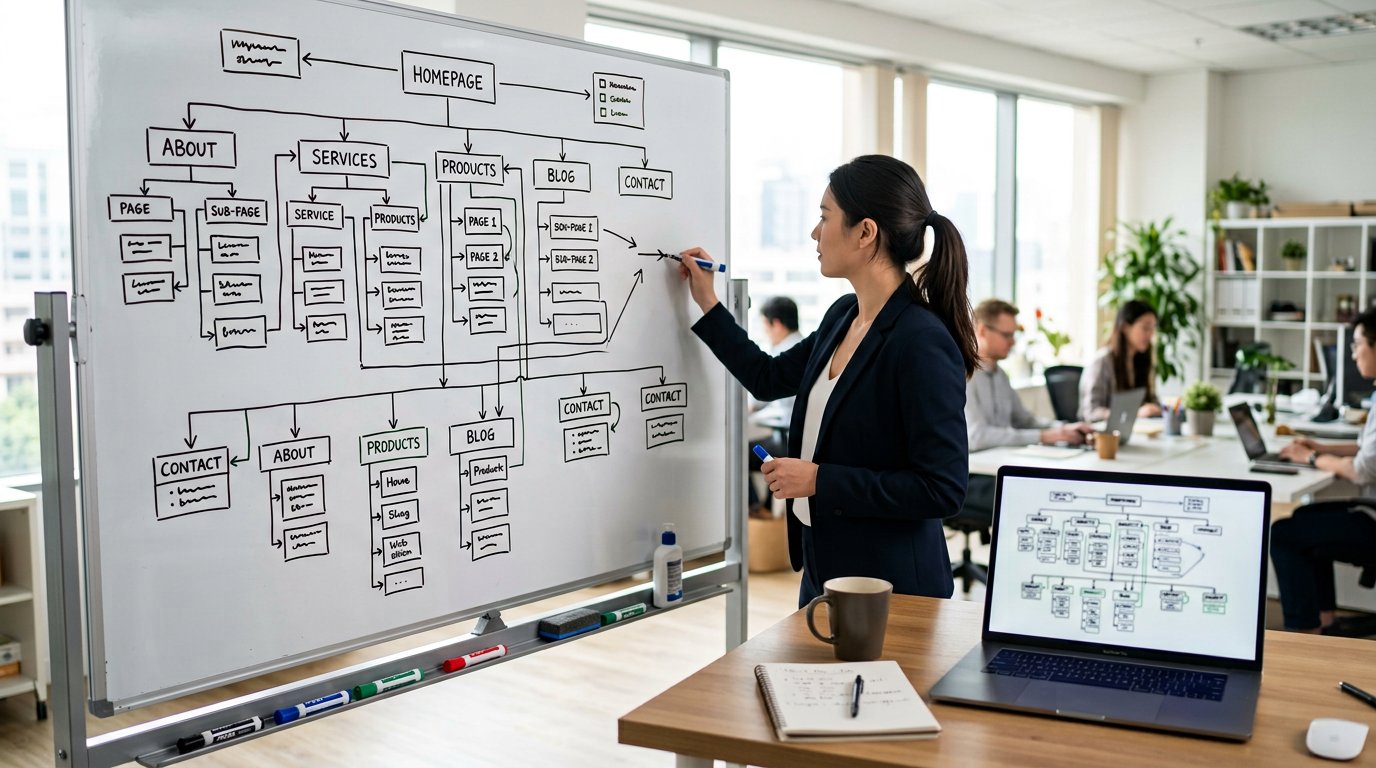
Начинать стоит не с закрытия всего подряд, а с ключевых страниц. Сначала убедитесь, что важные адреса открыты, находятся в sitemap и доступны в один-два клика с главной. Внутренние ссылки — самый надёжный способ показать роботу, что важно, и они же помогают людям.
Дальше наведите порядок в служебных адресах. Тут важно понимать разницу между запретом обхода и запретом индексации: закрытый в robots.txt адрес робот не обходит, а значит, может не увидеть на нём директиву noindex. Если задача — исключить страницы из индекса, но оставить их доступными, разумнее ставить noindex и разрешать обход. Если страницы не нужны совсем — закрывать и то, и другое.
- Проверьте robots.txt и карту сайта: там не должно быть противоречий.
- Сведите к минимуму параметры в адресах, а фильтры, которые нужны людям, оставьте открытыми только для главных категорий.
- Соберите sitemap из действительно полезных страниц, без мусора.
- Уберите битые ссылки и сократите цепочки редиректов: каждый лишний шаг отнимает время.
- Ускорите сайт: кэш, сжатие, нормальная работа сервера под нагрузкой.
Полезно посмотреть и на пагинацию и фильтры — типовые решения там описаны шаг за шагом.
Приоритеты в карте сайта
Sitemap — не список всего, что есть на сайте, а список того, что вы хотите показать поиску. Есть несколько правил, которые я проверяю всегда. Файл должен содержать только канонические адреса: если страница отдаёт 301, в карте ей не место. Дата изменения должна обновляться по факту, а не каждый раз при генерации, иначе robots перестанут ей доверять.
Крупные проекты удобно делить: отдельные карты для товаров, статей, изображений, видео. Так видно, что именно попадает в индекс, а что застревает. И ещё момент — не стоит складывать в карту десятки тысяч адресов, которые не нужны людям: она превращается в свалку, и пользы от неё нет.
Гигиена адресов
Часть бюджета уходит на дубли одного и того же адреса: с www и без, с большими буквами в параметрах, со слэшем и без, с разными вариантами сортировки. Все варианты должны вести на один канонический адрес, а остальные — отдавать редирект или закрываться. Проверьте это на всех разделах, а не только на главной.
Ещё один источник потерь — устаревший формат адресов, который вы когда-то использовали. Старые ссылки, оставшиеся внутри сайта, тянут робота в прошлое. Раз в полгода полезно прогонять сайт сканером и убирать такие находки. Мы разбирали смежную тему в статье про редиректы и зеркала, если хочется посмотреть глубже.
Чего делать не стоит
Самая частая ошибка — закрыть robots.txt для всего каталога «чтобы не тратили бюджет». Через месяц выясняется, что новые позиции перестали появляться, а структура раздела исчезла из выдачи. Экономия обхода не должна превращаться в потерю видимости.
Второе — надеяться, что настройки дадут эффект мгновенно. Поиск перестроит поведение обхода не сразу, обычно речь о неделях. Если через пару недель ничего не изменилось, стоит перепроверить настройки, а не менять их снова.
Что ускоряет индексацию новинок
Даже при нормальном бюджете новые страницы иногда ждут своего часа. На практике быстрее всего работают три вещи: ссылка с уже проиндексированной и регулярно обновляемой страницы, попадание в sitemap с корректной датой и появление страницы в разделе, который робот обходит часто. Иногда стоит пройтись вручную и поставить ссылку на новинку с главной или с популярной статьи.
Помогает и внутренняя логика: если новый раздел связан с другими разделами перелинковкой, а не висит особняком, обход приходит сам. Одиночные страницы, до которых можно добраться только через поиск по сайту, живут хуже всего.
Как измерить результат
- Частота обхода важных разделов: растёт или нет.
- Время от публикации до появления в индексе.
- Доля запросов робота к мусорным адресам в логах.
- Число «обнаружено, но не проиндексировано» по разделам.
Смотреть нужно на динамику за месяц-два, а не за один день: обход меняется медленно, зато потом держится стабильно.
Вывод
Краулинговый бюджет — это не отдельная настройка, а сумма технических решений: скорость, структура, ссылки, чистота адресов. Начните с логов, найдите трёх главных «пожирателей», уберите их и посмотрите, как изменится индексация. Для большинства проектов этого достаточно, чтобы новые страницы стали находить себя в выдаче быстрее.